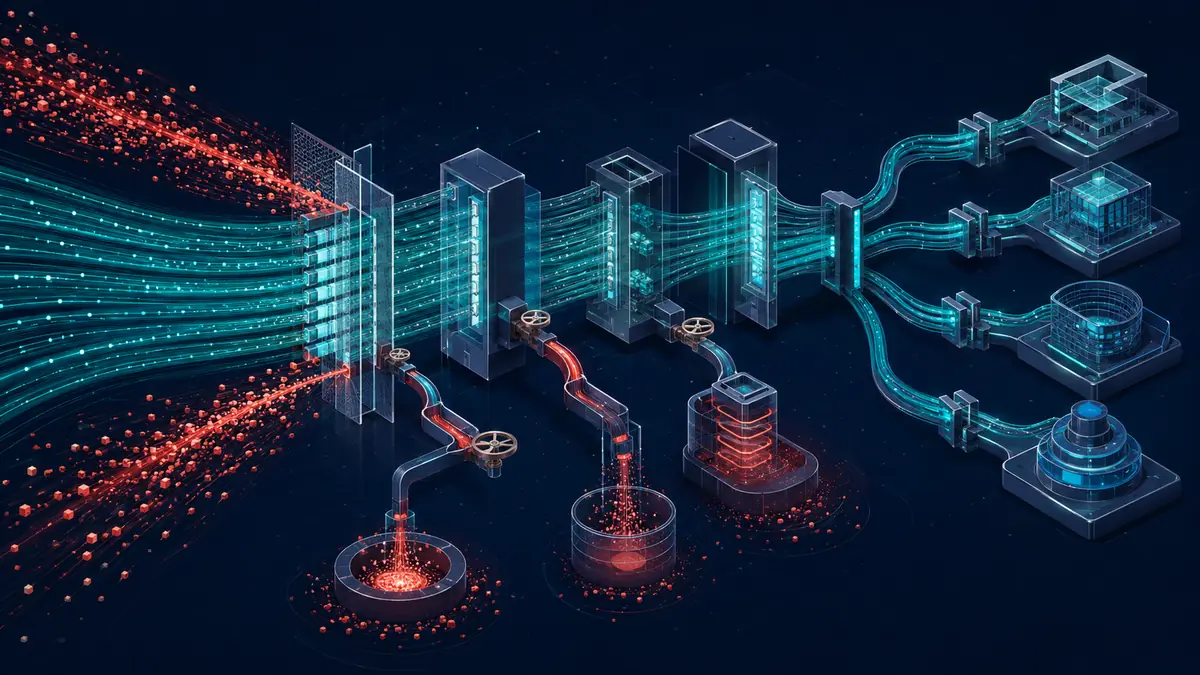
Un solo limite per tutto l’ecommerce è il limite sbagliato
Il rate limiting protegge disponibilità, costi e flussi sensibili, ma una regola uniforme può trasformarsi in un guasto autoindotto. Un login fallito, una lettura di catalogo, l’aggiornamento del carrello, l’avvio di un pagamento e una sincronizzazione di partner consumano risorse diverse e hanno conseguenze diverse per il cliente.
OWASP include tra i rischi delle API il consumo non limitato di CPU, memoria, banda, storage e servizi esterni a pagamento. La sua indicazione operativa è calibrare i limiti sulle esigenze di business e distinguere gli endpoint più sensibili. L’obiettivo, quindi, non è scegliere un numero universale: è progettare un sistema di budget, identità, priorità e degradazione che protegga login e checkout senza rendere fragile l’esperienza di acquisto.
Preparare inventario, identità e baseline
Classificare operazioni e costo reale
Parti da un inventario di route, metodo HTTP, autenticazione, dipendenze e costo. Per ogni operazione annota se legge cache o database, modifica stato, chiama un provider, avvia lavoro asincrono o può moltiplicare il carico tramite paginazione, filtri o batch. La documentazione Shopify mostra, per esempio, un modello GraphQL basato sul costo della query e un bucket che recupera capacità nel tempo. È un esempio di perché il solo conteggio delle richieste può essere troppo grossolano.
Scegliere chiavi che rappresentino il soggetto
La matrice iniziale deve associare a ogni classe quattro elementi: chi viene contato, che cosa consuma budget, quale azione scatta e come recupera. L’indirizzo IP resta un segnale utile, non un’identità affidabile: reti aziendali, operatori mobili e famiglie possono condividerlo, mentre un bot può distribuire il traffico. Combina, dove disponibili e leciti, IP, sessione, account, identificatore client, tenant e credenziale API.
- Login: budget per IP e per identificatore account pseudonimizzato, con conteggio focalizzato sugli esiti falliti.
- Catalogo: budget più elastico per letture cacheabili, separando ricerca costosa, export e paginazione profonda.
- Carrello: chiave di sessione o utente e budget distinto per letture e mutazioni.
- Checkout: contesto di sessione, account e rischio, con capacità riservata ai passaggi già avviati.
- Integrazioni: chiave client, negozio o tenant, più limiti di concorrenza e costo.
Applicare una policy diversa a ogni percorso
Login e recupero account: contare il segnale di abuso
Per il login, conta separatamente tentativi totali ed esiti falliti. Cloudflare documenta la possibilità di separare l’espressione che incrementa il contatore da quella che applica la mitigazione, includendo anche codici di risposta del backend. Questo consente una progressione: osservazione, ritardo, verifica aggiuntiva e blocco temporaneo proporzionato, invece di un divieto immediato su tutta la navigazione. Mantieni messaggi non enumerabili, un percorso accessibile per l’utente legittimo e budget autonomi per password dimenticata, invio OTP e creazione account, perché possono generare costi esterni.
Catalogo: assorbire i picchi e isolare le query costose
Le pagine prodotto e categoria devono tollerare campagne e flash sale. Usa cache e CDN, consenti burst coerenti con la baseline e limita in modo più severo operazioni ad alto costo: ricerca combinatoria, ordinamenti non indicizzati, export, scraping ripetitivo e richieste con pagine o batch eccessivi. Imposta anche limiti su dimensione dei parametri, numero di elementi e tempo di esecuzione; OWASP chiarisce che il rate limiting da solo non copre tutto il consumo di risorse.
Carrello: proteggere le mutazioni senza perdere intenzioni
Una lettura del carrello è diversa da aggiunta, rimozione, ricalcolo promozione o stima di spedizione. Limita le mutazioni per sessione e rendi idempotenti quelle che possono essere ripetute dopo un timeout. Se la capacità è ridotta, preserva lo stato già salvato e rinvia soltanto il ricalcolo non essenziale; non svuotare il carrello né trasformare un retry in una seconda quantità. Osserva raffiche causate dal frontend stesso: doppio click, retry senza backoff e componenti che richiamano la stessa API possono sembrare traffico ostile.
Checkout: riservare capacità e degradare con precisione
Il checkout merita budget e code separati da catalogo e back office. Distingui avvio sessione, validazione indirizzo, quote di spedizione, applicazione promozioni, creazione dell’intento di pagamento e lettura dello stato. Le operazioni già avviate hanno priorità sulle nuove richieste; i servizi accessori possono degradare senza bloccare i passaggi indispensabili. Idempotenza, autenticazione e verifica antifrode restano controlli autonomi: il rate limiter non li sostituisce.
Integrazioni: budget per client, costo e concorrenza
API di ERP, PIM, marketplace e logistica richiedono quote per credenziale e tenant, limiti di concorrenza e code per il lavoro pesante. Pesa le operazioni per costo invece di trattare allo stesso modo una lettura puntuale e una sincronizzazione estesa. Quando un provider restituisce informazioni sul budget, usale per regolare il ritmo: Shopify, per esempio, espone nel risultato GraphQL dati sul costo e sullo stato del throttle. Su un limite a monte, applica backoff con jitter, rispetta le indicazioni ricevute e non amplificare il problema con retry paralleli.
Coordinare edge, gateway e applicazione
L’edge assorbe abuso evidente e protegge l’origine; il gateway applica quote per client e tenant; l’applicazione conosce account, esito e costo di business; worker e database impongono concorrenza, timeout e capacità. Le decisioni devono essere coerenti ma non duplicate alla cieca. Documenta precedenza, chiave, finestra, azione, proprietario e modalità di emergenza per ogni regola.
Restituire un 429 che il client possa gestire
RFC 6585 definisce 429 Too Many Requests per troppe richieste in un intervallo. La risposta dovrebbe spiegare la condizione e può includere Retry-After; lo standard non impone come identificare il soggetto né come contare. Per le API controllate, restituisci un corpo stabile con codice macchina, ambito del limite e identificatore di correlazione, senza rivelare segnali antifrode. Imposta Retry-After quando conosci un’attesa affidabile e impedisci che la risposta venga memorizzata in cache.
Nel frontend, blocca solo l’azione interessata, conserva input e carrello, evita loop automatici e mostra un messaggio comprensibile. Nei client server-to-server, usa retry limitati, backoff e jitter. Sotto un attacco estremo il server può anche non rispondere con 429 a ogni richiesta: lo stesso RFC osserva che produrre risposte consuma risorse. La strategia deve quindi includere protezioni di rete e capacità, non soltanto una risposta applicativa.
Tarare con rollout progressivo e test realistici
Inizia in modalità osservazione: registra quale regola avrebbe agito, ma non bloccare. Costruisci baseline per route, identità, paese, canale, ora, campagna e versione client; separa clienti reali, automazioni note, traffico sconosciuto ed errori del frontend. Scegli soglie a partire dalla distribuzione interna e dalla capacità misurata, poi verifica picchi, NAT condivisi, retry, perdita del cookie, campagne, code lente e indisponibilità del contatore.
- Distribuisci una policy su una sola classe di endpoint e una quota di traffico controllata.
- Confronta decisioni del limiter, risposta dell’origine e percorso cliente con un identificatore comune.
- Aumenta gradualmente la copertura, mantenendo override con scadenza e un kill switch verificato.
- Rivedi le regole dopo cambi di frontend, catalogo, campagne, provider o architettura.
Misurare protezione e clienti salvaguardati
Il cruscotto deve mostrare richieste ammesse, ritardate, verificate e rifiutate per policy; quota di 429 su sessioni considerate legittime; successo del login dopo una verifica; abbandono di carrello e checkout dopo una decisione; latenza, saturazione dell’origine e costi dei provider; retry conformi a Retry-After; disponibilità e latenza del limitatore. Segmenta per route, chiave, azione e versione, evitando etichette ad alta cardinalità non controllata.
Il runbook operativo prima del go-live
Verifica che ogni endpoint abbia proprietario, classe di costo, identità, budget, azione, risposta e dashboard. Testa credenziali errate distribuite, molti account da un IP condiviso, scraping del catalogo, mutazioni duplicate del carrello, timeout durante il pagamento, webhook o batch di partner, perdita del datastore dei contatori e riduzione improvvisa della quota di un provider.
Un buon rate limiting ecommerce è una politica di resilienza, non una barriera unica. Differenzia i percorsi, preserva la capacità del checkout, rende i client collaborativi e misura i falsi positivi insieme al traffico bloccato. Per progettare gateway, osservabilità e flussi affidabili, scopri i nostri servizi per ecommerce e sistemi. Se vuoi rivedere policy e piano di rollout, contatta AE Digital Agency.
Domande frequenti
Qual è una soglia corretta per il rate limiting di un ecommerce?
Non esiste una soglia universale. Va derivata dalla distribuzione del traffico legittimo, dal costo dell’operazione, dalla capacità misurata e dal rischio, poi verificata in osservazione e rollout progressivo.
Perché non basta limitare tutte le richieste per indirizzo IP?
Un IP può rappresentare molte persone dietro NAT, mentre un bot può distribuirsi su molti indirizzi. Conviene combinare IP con sessione, account pseudonimizzato, client, tenant e contesto della route.
Come si evita che il rate limiting blocchi il checkout?
Si separano i budget del checkout, si riserva capacità alle sessioni già avviate, si limita soltanto l’azione interessata e si mantengono stato, idempotenza, recupero e degradazione dei servizi accessori.
Che cosa deve contenere una risposta HTTP 429?
Un corpo stabile dovrebbe spiegare l’ambito del limite e offrire un codice macchina e una correlazione. Quando l’attesa è nota, può includere Retry-After; il client deve evitare retry immediati e infiniti.
Articoli correlati
Passkey per ecommerce: rollout controllato tra login, checkout e recupero account
Un runbook operativo per introdurre le passkey senza bloccare guest checkout o utenti esistenti: flussi WebAuthn, fallback, recovery, metriche e rollout progressivo.
Content Security Policy per ecommerce: rollout sicuro tra checkout e analytics
Una guida operativa per introdurre la CSP senza bloccare pagamenti, consenso e misurazione: inventario, Report-Only, nonce, test dei percorsi e canary.
Webhook ecommerce affidabili: idempotenza, retry e osservabilità
Un blueprint operativo per ricevere eventi di ordini e pagamenti, evitare effetti duplicati, recuperare gli errori e rendere misurabile l'intera pipeline.