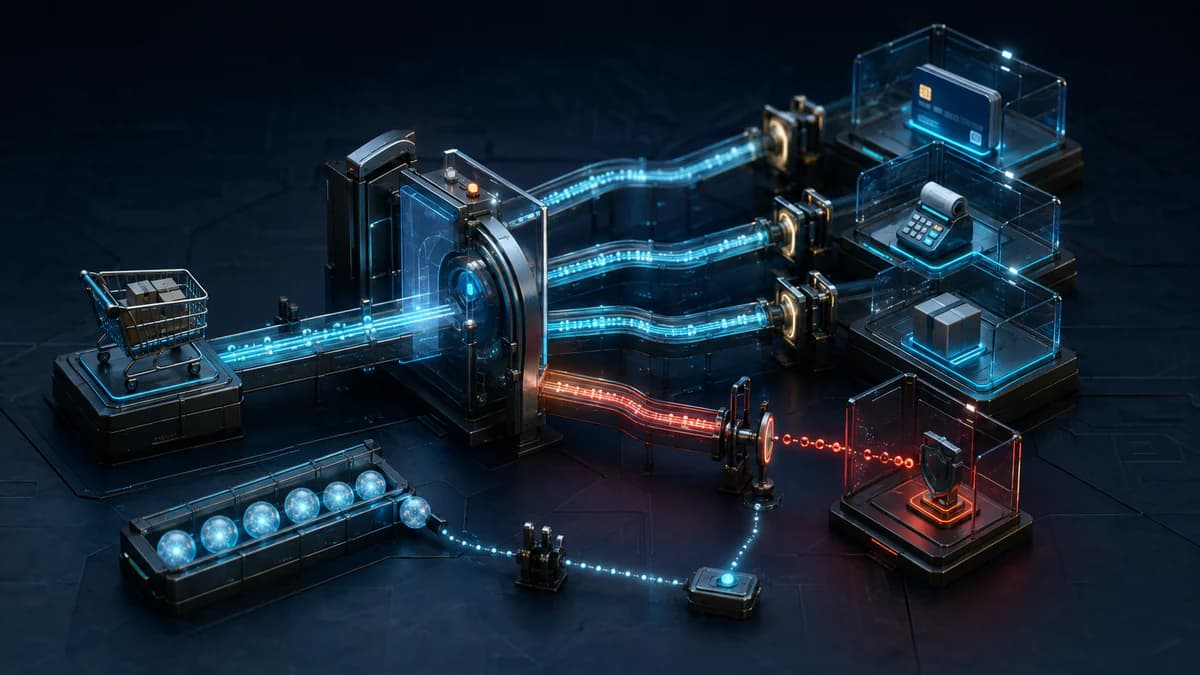
Un guasto locale non deve diventare un fermo del checkout
Un acquisto attraversa spesso più sistemi di quanto mostri l’interfaccia: catalogo, carrello, promozioni, tasse, antifrode, pagamento, inventario e promessa di consegna. Se uno di questi rallenta, il rischio non è soltanto una risposta tardiva. Ogni richiesta in attesa trattiene connessioni, thread, memoria e capacità nei pool; nuove richieste si accodano e il servizio sano inizia a degradare insieme a quello guasto. È così che una dipendenza esterna circoscritta può produrre un errore a cascata.
Il circuit breaker serve a contenere questo effetto. Non ripara il fornitore remoto: protegge il chiamante, interrompendo rapidamente le richieste quando la probabilità di successo è troppo bassa. Per un ecommerce, la progettazione utile parte dalle capacità di business e non dalla libreria tecnica. Autorizzare un pagamento, calcolare un dazio, verificare una frode e mostrare una stima di consegna hanno rischi e possibilità di fallback differenti.
Mappare dipendenze e semantica prima delle soglie
Per ogni passaggio del percorso, conviene registrare proprietario, criticità, modalità di errore, idempotenza e comportamento degradato ammesso. Una matrice semplice distingue le capacità obbligatorie da quelle rinviabili. Se il gateway di pagamento non conferma l’autorizzazione, l’ordine non può essere dichiarato pagato. Se un servizio di raccomandazione è indisponibile, invece, il checkout può continuare senza suggerimenti. Se la stima precisa di consegna manca, può essere lecito mostrare una finestra più prudente, purché sia chiaro al cliente.
Definire il confine della correttezza
Un fallback non è una risposta qualsiasi: deve conservare le invarianti del dominio. Riutilizzare una tassa memorizzata può essere accettabile solo se territorio, prodotto e validità lo consentono. Accettare alla cieca un controllo antifrode non lo è. La decisione va approvata da prodotto, operations, sicurezza e compliance, poi resa esplicita nel contratto del servizio. Senza questo confine, il circuit breaker rischia di sostituire un’interruzione visibile con dati commercialmente errati.
Costruire una deadline end-to-end
Il timeout di una singola chiamata non coincide con il tempo disponibile per l’intero checkout. Il browser, l’edge, l’applicazione, gli orchestratori e i fornitori consumano tutti una parte della stessa deadline. Se ogni livello assegna un timeout indipendente e completo, l’ultimo tentativo può continuare quando il cliente ha già abbandonato. La deadline residua deve quindi essere propagata e ogni componente deve rifiutare lavoro che non può più produrre un risultato utile.
I valori numerici dipendono dai percentili osservati, dal margine di rete, dall’importanza della funzione e dal budget di esperienza; non esiste una soglia universale. Un esempio puramente illustrativo può riservare una quota del budget alla risposta dell’applicazione, una alla dipendenza e una al fallback. Il principio verificabile è che la somma delle fasi, inclusi accodamento e possibili tentativi, rimanga entro il limite del percorso.
Separare connessione, lettura e coda
Un unico timeout opaco nasconde dove si spende il tempo. È più utile osservare attesa nel pool, apertura della connessione, negoziazione, elaborazione remota e lettura della risposta. Il limite deve coprire l’intera operazione prevista dalla piattaforma, senza lasciare fasi non protette. La capacità dei pool resta finita: per questo il disegno va coordinato con il dimensionamento delle connessioni ecommerce.
Usare il circuit breaker come macchina a stati
Nello stato chiuso le richieste passano e gli esiti alimentano una finestra di salute. Quando la politica rileva un degrado significativo, il circuito si apre e restituisce subito un errore controllato o un fallback, evitando di consumare altre risorse remote. Dopo un intervallo di recupero entra nello stato semiaperto: lascia passare un numero limitato di sonde. Se sono sane, richiude gradualmente; se falliscono, torna aperto.
La chiave del circuito dovrebbe rappresentare la vera unità di guasto. Un solo breaker globale per tutti i fornitori può fermare capacità sane; uno per singolo utente può non raccogliere abbastanza segnali. Spesso servono confini per fornitore, endpoint, regione o operazione. Anche gli errori contano diversamente: un rifiuto valido della carta non indica indisponibilità, mentre timeout, errori di rete e risposte server possono contribuire alla salute operativa.
Evitare oscillazioni e recuperi aggressivi
Finestre troppo brevi reagiscono al rumore; finestre troppo lunghe proteggono tardi. Il recupero non deve riaprire simultaneamente tutto il traffico verso un servizio appena tornato disponibile. Sonde limitate, incremento progressivo e jitter distribuiscono la domanda nel tempo. Le soglie vanno calibrate su dati di produzione e prove controllate, non copiate da un altro sistema.
Limitare i retry con un budget condiviso
I retry possono recuperare errori transitori, ma moltiplicano il carico. Se ogni livello ripete la chiamata, pochi tentativi locali diventano molte richieste sul sistema già in difficoltà. La politica deve stabilire un solo punto responsabile del retry, richiedere operazioni idempotenti o chiavi di idempotenza e imporre un budget. Il retry budget esprime quanta domanda aggiuntiva è ammessa rispetto al traffico originale e si esaurisce quando la dipendenza peggiora.
Tra i tentativi serve un backoff crescente con jitter, così i client non si sincronizzano in ondate. Un tentativo non va avviato se la deadline residua non basta o se il breaker è aperto. Gli errori permanenti, i rifiuti di business e le richieste non sicure non devono essere ripetuti automaticamente. Il retry è quindi una decisione selettiva, non una reazione predefinita a ogni errore.
Isolare risorse con bulkhead e controllo della pressione
Il breaker limita chiamate future, ma quelle in corso e le code possono aver già occupato capacità. Il pattern bulkhead separa pool, code, worker o processi affinché un fornitore lento non consumi tutte le risorse del checkout. Pagamento e preventivo di spedizione possono avere budget di concorrenza distinti; una saturazione della seconda capacità non deve impedire alla prima di completare lavoro sano.
Le code devono essere limitate e accompagnate da rifiuto anticipato. Accettare lavoro senza limiti trasforma la memoria in una coda invisibile e aumenta la latenza fino al collasso. Rate limit e backpressure completano il disegno: il rate limiting delle API ecommerce controlla l’ingresso, mentre bulkhead e breaker governano come quel traffico usa le dipendenze in uscita.
Osservare decisioni, non soltanto errori
Una dashboard utile separa latenza, timeout, saturazione, rifiuti, tentativi aggiuntivi e risultati per dipendenza e operazione. Deve mostrare lo stato del breaker, il motivo delle transizioni, la quantità di traffico servita dal fallback, il budget di retry consumato e la salute delle sonde. Le metriche aggregate del checkout possono sembrare normali mentre una regione o un endpoint degrada.
Trace e log devono collegare la deadline originale alle chiamate figlie senza registrare dati sensibili. Un identificatore di operazione permette di capire se più tentativi appartengono allo stesso acquisto. Il tracing distribuito del checkout aiuta a distinguere tempo di coda, elaborazione e rete. Gli alert dovrebbero descrivere impatto sulle capacità: quota di checkout senza stima, pagamenti sospesi o fallback antifrode, non solo conteggi tecnici.
Provare il degrado e governare il rilascio
Il comportamento resiliente va testato introducendo latenza, errori, connessioni interrotte e capacità ridotta in ambienti controllati. La prova deve verificare che la deadline venga rispettata, il budget di retry resti limitato, il circuito apra e recuperi senza tempeste, i bulkhead preservino le funzioni sane e il cliente riceva un messaggio coerente. È importante provare anche il ritorno alla normalità, quando cache e code possono contenere lavoro arretrato.
Una checklist di rilascio assegna proprietari a soglie e fallback, collega runbook e dashboard, documenta l’interruttore operativo e definisce quando disabilitare una funzione. I valori sono ipotesi da validare con traffico e test, non costanti universali. Se vuoi progettare questi controlli sul percorso reale del tuo store, puoi confrontare dipendenze, invarianti e capacità con i nostri servizi per sistemi ecommerce. Il risultato atteso non è l’assenza di guasti, ma un guasto circoscritto, osservabile e recuperabile.
Domande frequenti
Qual è la differenza tra circuit breaker e retry?
Il retry ripete una richiesta quando esiste una ragionevole probabilità di recupero; il circuit breaker sospende temporaneamente le chiamate quando i segnali indicano che insistere aggraverebbe il guasto. Sono controlli complementari, non intercambiabili.
Ogni dipendenza del checkout deve avere lo stesso timeout?
No. Il timeout deriva dal budget end-to-end, dalla criticità della capacità e dal comportamento misurato della dipendenza. Pagamento, tasse, antifrode e spedizione possono avere semantiche e fallback diversi.
Quando è sicuro degradare una funzione ecommerce?
Solo quando il fallback conserva correttezza, trasparenza e vincoli di rischio. Una stima di consegna può essere differita; un’autorizzazione di pagamento o un controllo normativo non devono essere inventati.
Come si verifica il comportamento prima della produzione?
Con test controllati che introducono latenza, errori e capacità ridotta, osservando deadline, aperture del circuito, code, pool, fallback e recupero. I criteri di rilascio devono includere anche la modalità degradata.
Articoli correlati
Connection pooling ecommerce: dimensionamento, timeout e capacità del database
Un metodo operativo per assegnare il budget di connessioni, governare le code e impedire che picchi di checkout trasformino il pool in un moltiplicatore di guasti.
Rate limiting delle API ecommerce: proteggere login e checkout senza bloccare i clienti
Un modello operativo per applicare limiti diversi a login, catalogo, carrello, checkout e integrazioni, con risposte 429 utili e metriche sui falsi positivi.
Tracing distribuito ecommerce: diagnosticare checkout e ordini con OpenTelemetry
Un metodo operativo per tracciare checkout e ordini, propagare il contesto, correlare provider, proteggere i dati e campionare senza perdere gli incidenti.