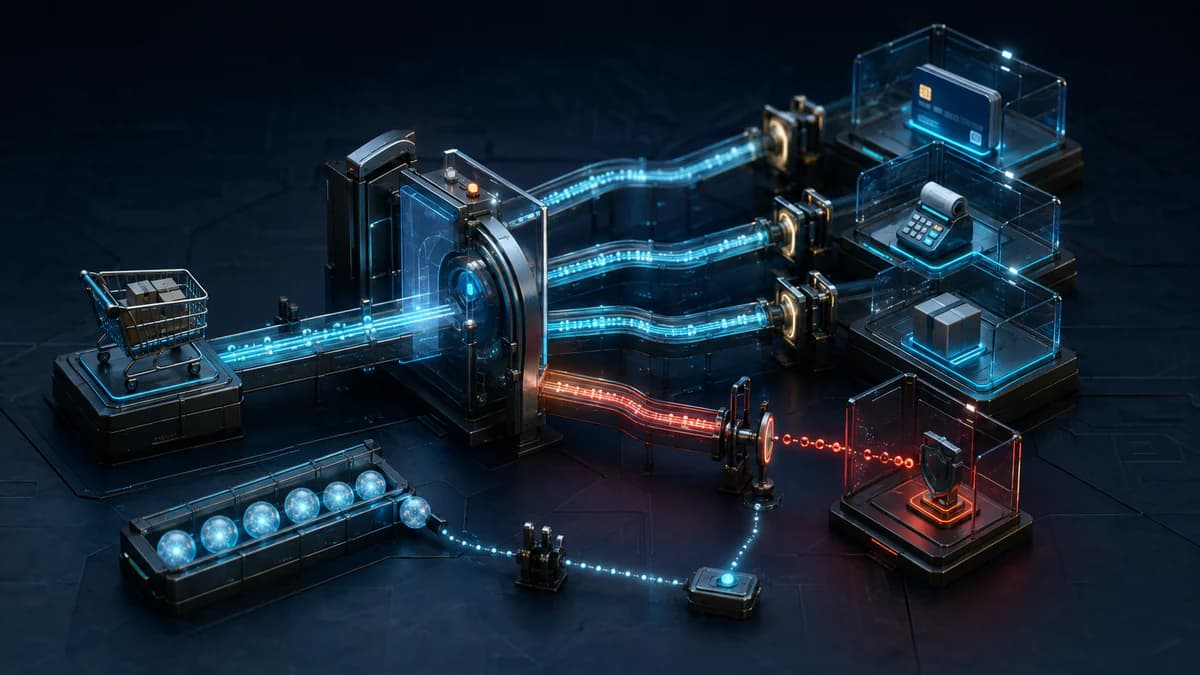
Une panne locale ne doit pas arrêter tout le checkout
Un achat mobilise davantage de systèmes que l’interface ne le laisse voir : panier, promotions, fiscalité, contrôle antifraude, paiement, stock et promesse de livraison. Lorsqu’une dépendance ralentit, le problème dépasse la réponse tardive. Le travail en attente retient connexions, threads, mémoire et capacité des pools ; les nouvelles requêtes s’accumulent jusqu’à dégrader un service pourtant sain. L’incident limité d’un fournisseur devient alors une panne en cascade.
Le mécanisme de circuit breaker contient cet effet. Il ne répare pas le fournisseur distant : il protège l’appelant en interrompant les appels dont la réussite est devenue improbable. Une architecture ecommerce robuste se conçoit donc à partir des fonctions métier. Autoriser un paiement, calculer une taxe, évaluer le risque de fraude et estimer une livraison présentent des risques et des replis différents.
Cartographier les dépendances avant les seuils
Pour chaque étape, il faut consigner le responsable, le niveau de criticité, les modes de panne, les exigences d’idempotence et le comportement dégradé autorisé. Une matrice distingue les décisions obligatoires des données complémentaires pouvant être différées. Sans confirmation du prestataire, une commande ne peut pas être déclarée payée. Si les recommandations échouent, le checkout peut continuer. Si l’estimation précise de livraison manque, une fenêtre prudente peut convenir à condition d’informer clairement le client.
Définir les règles de validité métier
Un repli n’est pas une réponse arbitraire : il préserve les invariants métier. Réutiliser un montant de taxe mis en cache n’est valable que pour un territoire, un produit et une durée compatibles. Approuver silencieusement une décision antifraude absente ne l’est pas. Produit, exploitation, sécurité et conformité doivent approuver la règle et l’inscrire dans le contrat de service. Sinon, le circuit remplace une interruption visible par une donnée commerciale fausse.
Construire une échéance de bout en bout
Le délai d’un appel n’est pas le temps total disponible pour le checkout. Navigateur, couche edge, application, orchestrateurs et fournisseurs consomment chacun une partie de la même échéance. Si chaque couche redémarre un délai complet, un dernier essai peut continuer après le départ du client. Il faut propager le temps restant et refuser un travail qui ne peut plus produire de résultat utile.
Les valeurs dépendent des percentiles observés, de la marge réseau, de l’importance de la fonction et du budget temporel du parcours client ; aucun réglage n’est universel. À titre purement illustratif, une équipe peut réserver des portions au traitement applicatif, à la dépendance et au repli. La règle vérifiable est que file d’attente, traitement et essais autorisés restent dans la limite du parcours.
Distinguer connexion, file et lecture
Un délai unique et opaque masque où le temps disparaît. Il vaut mieux observer attente du pool, ouverture de connexion, négociation, traitement distant et lecture de réponse. La limite doit couvrir l’opération complète telle que la plateforme l’exécute. Les pools restent finis : ce travail accompagne le dimensionnement des connexions ecommerce.
Traiter le breaker comme une machine à états
À l’état fermé, les appels sont transmis et leurs résultats alimentent une fenêtre d’observation de l’état du service. Quand la politique détecte une dégradation significative, le circuit s’ouvre et renvoie immédiatement une erreur contrôlée ou un repli, économisant les ressources. Après un intervalle de récupération, il passe en semi-ouvert et admet quelques sondes. Des sondes saines permettent une fermeture progressive ; de nouveaux échecs le rouvrent.
La clé de partitionnement du circuit doit correspondre à l’unité réelle de panne. Un circuit global peut couper des fournisseurs sains ; un circuit par client recueille parfois trop peu de signaux. Les frontières suivent souvent fournisseur, point de terminaison, région ou opération. La classification compte : un refus légitime de carte n’est pas une indisponibilité, contrairement à certains délais dépassés, erreurs réseau ou échecs serveur.
Éviter les oscillations et l’afflux à la reprise
Une fenêtre trop courte réagit au bruit ; trop longue, elle protège trop tard. La reprise ne doit pas libérer simultanément tout le trafic vers un service qui revient. Sondes limitées, admission progressive et jitter répartissent la demande. Les seuils se calibrent avec les données de production et des essais contrôlés, jamais par simple copie.
Limiter les réessais par un budget partagé
Les réessais corrigent parfois une panne transitoire, mais multiplient la charge. Si chaque couche recommence, une petite règle locale devient une foule d’appels vers une dépendance déjà fragile. Une seule couche doit piloter les réessais, avec des opérations idempotentes ou des clés d’idempotence et un budget obligatoire. Le budget de réessais exprime la demande supplémentaire admise par rapport au trafic initial et s’épuise lorsque l’état du service se dégrade.
Un délai d’attente progressif assorti d’une composante aléatoire évite le retour synchronisé des clients. Aucun essai ne démarre si l’échéance restante est insuffisante ou si le circuit est ouvert. Erreurs permanentes, refus métier et opérations non sûres ne doivent pas être répétés automatiquement. Réessayer est une décision sélective, pas la réponse par défaut à toute exception.
Isoler les ressources par cloisonnement
Le circuit limite les appels futurs, mais les opérations en cours et les files peuvent déjà occuper la capacité. Le cloisonnement de type bulkhead sépare les pools de ressources, les files, les unités de traitement ou les processus pour qu’un fournisseur lent ne consomme pas toutes les ressources. Paiement et devis de livraison peuvent disposer de limites propres de traitements simultanés ; la saturation du calcul de livraison ne doit pas interrompre le paiement.
Les files doivent être bornées et associées à un rejet anticipé. Accepter un travail illimité transforme la mémoire en file cachée et étire la latence jusqu’à l’effondrement. Limitation de débit et backpressure complètent le dispositif : la limitation de débit des API ecommerce contrôle l’entrée, tandis que le cloisonnement et les circuits gouvernent les dépendances sortantes.
Observer les décisions et leur impact
Un tableau utile sépare latence, délais dépassés, saturation, rejets, essais supplémentaires et résultats par dépendance et opération. Il affiche l’état du circuit, la cause des transitions, le volume de réponses de repli, la consommation du budget et le résultat des sondes. Une moyenne globale peut sembler normale pendant qu’une région ou un point de terminaison rencontre une panne.
Les traces et journaux relient l’échéance initiale aux sous-appels sans exposer de données sensibles. Un identifiant d’opération révèle si plusieurs essais concernent le même achat. Le traçage distribué du checkout distingue file, traitement et réseau. Les alertes doivent décrire l’impact métier, comme les checkouts sans estimation ou les paiements suspendus.
Tester la dégradation et gouverner la livraison
Le comportement résilient se vérifie en injectant latence, erreurs, connexions rompues et capacité réduite dans un cadre contrôlé. Il faut confirmer le respect de l’échéance, le plafonnement des réessais, l’ouverture et la reprise sans ruée, la protection des fonctions saines par le cloisonnement des ressources et la clarté du message client. Le retour à la normale mérite aussi un test, car files et caches peuvent contenir du travail retardé.
Une liste de contrôle attribue les seuils et les stratégies de repli à des responsables, puis relie les procédures d’exploitation aux tableaux de bord, documente l’interrupteur opérationnel et précise quand désactiver une fonction. Toute valeur numérique reste une hypothèse à valider, jamais une constante universelle. Pour appliquer ce modèle à une boutique réelle, cartographiez dépendances, invariants et capacité avec nos services d’architecture et d’intégration ecommerce. La réussite n’est pas l’absence de panne, mais une panne contenue, observable et récupérable.
Questions fréquentes
Quelle différence existe entre circuit breaker et réessai ?
Le réessai répète une requête quand une récupération reste plausible ; le circuit breaker suspend temporairement les appels quand les signaux montrent qu’insister amplifierait la panne. Ces contrôles sont complémentaires.
Toutes les dépendances du checkout doivent-elles partager le même délai ?
Non. Le délai découle du budget global, du caractère critique de la fonction et du comportement mesuré. Paiement, fiscalité, contrôle antifraude et livraison peuvent exiger des règles et des stratégies de repli différentes.
Quand peut-on dégrader une fonction ecommerce sans danger ?
Seulement si le repli préserve l’exactitude, la transparence et les contraintes de risque. Une estimation de livraison peut attendre ; une autorisation de paiement ou un contrôle réglementaire ne doit jamais être inventé.
Comment vérifier ce comportement avant la production ?
Par des tests contrôlés qui injectent latence, erreurs et capacité réduite, puis observent échéances, transitions du circuit, files, pools, replis et reprise. Les critères de livraison doivent couvrir le mode dégradé.
Articles connexes
Pooling de connexions ecommerce : dimensionnement, délais et capacité
Une méthode opérationnelle pour répartir le budget de connexions, maîtriser les files et éviter qu'un pic de checkout transforme le pool en amplificateur de panne.
Limitation de débit des API e-commerce : protéger la connexion et le checkout sans bloquer les clients
Un modèle opérationnel pour différencier connexion, catalogue, panier, checkout et intégrations, avec des réponses 429 exploitables et des métriques de faux positifs.
Traçage distribué e-commerce : diagnostiquer le checkout et les commandes avec OpenTelemetry
Une méthode opérationnelle pour tracer le checkout et les commandes, propager le contexte, corréler les prestataires, protéger les données et échantillonner les traces sans perdre les incidents utiles.