Il problema non è inviare un evento, ma coordinarlo con l’ordine
Quando un cliente conclude un acquisto, il servizio ordini deve modificare il proprio database e comunicare il fatto ad altri sistemi: magazzino, fatturazione, email, analytics o antifrode. La soluzione apparentemente semplice esegue due scritture separate: salva l’ordine e pubblica un messaggio. Proprio in questo intervallo nasce il dual write problem. Se il database conferma e il broker non riceve l’evento, l’ordine esiste ma i processi a valle non partono. Se il messaggio parte prima e il salvataggio fallisce, i consumatori reagiscono a un ordine inesistente.
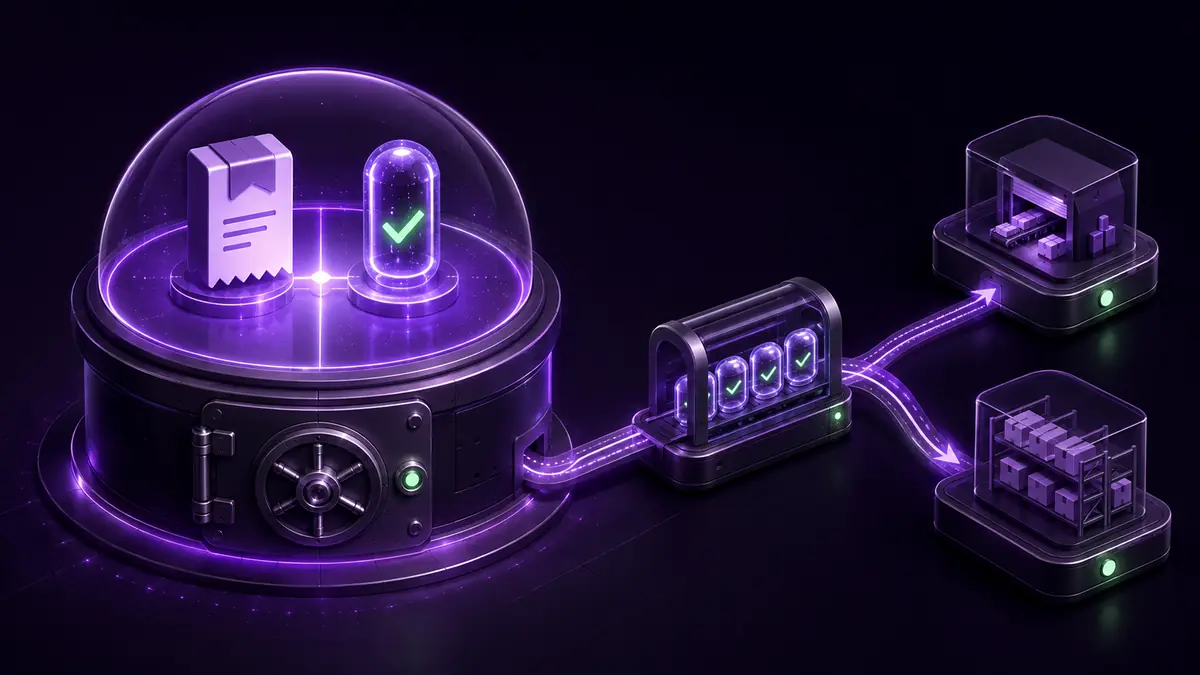
Una transazione distribuita potrebbe coordinare più risorse, ma spesso non è disponibile, desiderabile o supportata dall’intero stack. Il transactional outbox restringe invece il confine atomico a un solo database. Nella stessa transazione locale che crea o aggiorna l’ordine, l’applicazione inserisce una riga outbox che descrive l’evento. Un processo separato la inoltra in seguito. Così ordine ed evento da pubblicare diventano visibili insieme oppure non diventano visibili affatto.
Disegnare l’outbox come parte del modello operativo
La tabella outbox non è una cartella temporanea senza contratto. Ogni record dovrebbe avere un identificatore evento stabile, il tipo, l’identificatore dell’aggregato, la versione o sequenza, la data di creazione e il payload minimo necessario. L’aggregato può essere l’ordine, il pagamento o la prenotazione di inventario. Una chiave come order_id consente di preservare l’ordine relativo degli eventi appartenenti alla stessa entità quando il trasporto lo supporta.
Il payload non dovrebbe essere una copia indiscriminata delle tabelle. Un evento descrive un fatto di dominio già avvenuto, con un contratto versionabile e senza segreti, token di pagamento o dati personali superflui. La riga può includere intestazioni tecniche per correlazione e tracciamento, ma il suo schema deve restare comprensibile ai consumatori. Prima di implementare, vanno definiti proprietario, evoluzione, politiche di compatibilità e classificazione dei dati.
Una sola transazione locale per stato ed evento
L’inserimento nell’outbox deve avvenire nello stesso commit della modifica di business. Salvare l’ordine, confermare e poi aprire una seconda transazione per l’evento ricrea esattamente la finestra che il pattern deve eliminare. Anche i framework che raccolgono eventi in memoria devono svuotare quella raccolta dentro la transazione corrente e fallire l’intero commit se l’outbox non è scrivibile.
Scegliere tra polling relay e change data capture
Un polling publisher interroga periodicamente le righe non elaborate, pubblica i messaggi e registra l’avanzamento. È esplicito, portabile e facile da comprendere, ma richiede attenzione a concorrenza e locking. In PostgreSQL, più worker possono selezionare lotti con un ordine deterministico e usare FOR UPDATE SKIP LOCKED per evitare che elaborino le stesse righe bloccate. Questa tecnica distribuisce lavoro da una tabella simile a una coda, ma non sostituisce una politica di retry né rende equo l’accesso tra record.
La change data capture legge invece le modifiche dal log del database. Un connettore può intercettare gli insert dell’outbox e trasformarli in eventi instradati verso topic appropriati. Debezium documenta un Outbox Event Router che usa campi come identificatore aggregato, tipo e payload per costruire la struttura del messaggio. La CDC riduce il polling applicativo, ma introduce un’infrastruttura con offset, connettori, permessi e procedure di ripristino da governare.
La scelta dipende dal modello di esercizio
Il polling è spesso adatto quando il volume è gestibile e il team vuole possedere un relay semplice nel proprio runtime. La CDC è utile quando esiste già una piattaforma di streaming gestita e il log del database è una fonte operativa ben presidiata. In entrambi i casi occorre misurare ritardo tra commit e pubblicazione, backlog, errori e capacità di recupero. Non è la tecnologia a garantire correttezza: sono il confine transazionale e le invarianti verificate.
Accettare la consegna almeno una volta e progettare l’idempotenza
Il relay può arrestarsi dopo aver pubblicato un messaggio ma prima di registrare che la riga è stata elaborata. Al riavvio lo pubblicherà di nuovo. Questo rende le duplicazioni un comportamento normale di una pipeline almeno una volta. Il pattern non autorizza quindi a dichiarare una semantica end-to-end exactly once: broker, relay, consumer e sistemi esterni hanno confini di conferma diversi.
Ogni consumer deve riconoscere l’identificatore evento. Un inbox locale o una tabella di deduplicazione può registrarlo nella stessa transazione con cui applica l’effetto. Se l’identificatore è già presente, il consumer conferma senza ripetere l’operazione. Per effetti esterni, come una richiesta a un provider di pagamento, servono anche chiavi di idempotenza supportate dal destinatario e una riconciliazione separata. La deduplica non deve scadere prima della massima finestra realistica di retry o replay.
Preservare l’ordine per aggregato, non in modo globale
Molti flussi richiedono che OrderCreated preceda OrderCancelled per lo stesso ordine, non che tutti gli eventi del negozio siano serializzati. Una sequenza monotona per aggregato, una chiave di partizione coerente e un consumer che rifiuta o accantona versioni fuori ordine rendono questa regola verificabile. Un ordinamento globale riduce parallelismo e raramente rappresenta un requisito di business reale.
Governare retry, retention e quarantena
Il relay deve distinguere errori transitori da record non pubblicabili. I primi seguono retry limitati con backoff e jitter; i secondi passano in quarantena con motivo, payload protetto e procedura di correzione. Ritentare senza limiti un record malformato può bloccare il lotto o consumare capacità. Una corsia separata consente al resto dell’outbox di avanzare senza cancellare le prove del problema.
La retention bilancia audit, replay e costo. Eliminare subito le righe pubblicate rende difficile ricostruire incidenti; conservarle per sempre degrada indici e query. È preferibile archiviare o partizionare secondo una politica esplicita, conservando identificatori e metadati necessari alla deduplica. Un replay deve essere autorizzato, limitato per intervallo e osservabile, perché ripropone effetti di business anche quando il trasporto funziona correttamente.
Osservare la distanza tra commit e conseguenza
Le metriche principali includono età della riga non pubblicata più vecchia, profondità del backlog, latenza dal commit all’invio, tasso di pubblicazione, retry, quarantene e duplicati rilevati dai consumer. Vanno segmentate per tipo evento e aggregato critico. Un backlog basso può nascondere un singolo ordine bloccato; per questo contano sia le distribuzioni sia l’età massima.
Log e trace dovrebbero collegare event_id, aggregate_id, commit, tentativo del relay e consumo, senza esporre il payload sensibile. Gli alert devono descrivere l’impatto: ordini confermati senza prenotazione di stock, email ritardate o fatture in attesa. Dashboard e runbook devono indicare chi può mettere in pausa il relay, riprodurre un evento o sbloccare una quarantena.
Provare i crash nei punti scomodi
I test decisivi arrestano il processo dopo ogni confine: prima del commit, dopo il commit ma prima della lettura, dopo la pubblicazione ma prima dell’ack e durante l’effetto del consumer. A ogni riavvio si verifica che nessun evento manchi, che i duplicati siano innocui e che l’ordine per aggregato resti coerente. Vanno simulate anche indisponibilità del broker, crescita del backlog, righe malformate e perdita temporanea del connettore CDC.
Il rilascio può iniziare con osservazione in ombra, volumi limitati e riconciliazione tra ordini ed eventi. Una query periodica deve individuare ordini senza outbox, outbox troppo vecchie ed effetti a valle assenti. Se vuoi trasformare questa architettura in un flusso verificabile per checkout, magazzino e automazioni, esplora i nostri servizi ecommerce e sistemi oppure confrontati con il team. L’obiettivo non è promettere assenza di duplicati, ma rendere ogni stato recuperabile e ogni discrepanza osservabile.
Domande frequenti
Perché una doppia scrittura tra database e broker è rischiosa?
Perché i due sistemi possono confermare in momenti diversi: un crash può lasciare un ordine senza evento oppure un evento relativo a una modifica non confermata. L’outbox sposta entrambe le scritture in un solo commit locale.
Il transactional outbox garantisce una consegna exactly once?
No. Il relay può ripubblicare dopo un crash e i confini di conferma non sono unici. Il design assume consegna almeno una volta e rende i consumer idempotenti tramite identificatore evento, inbox o deduplica.
È meglio pubblicare l’outbox con polling o CDC?
Dipende dalla piattaforma operativa. Il polling è esplicito e portabile; la CDC usa il log del database e richiede gestione di connettori e offset. Entrambi devono misurare ritardo, backlog e recupero.
Come si mantiene l’ordine corretto degli eventi ecommerce?
Si usa una sequenza per aggregato, una chiave di partizione coerente e un consumer che controlla la versione. Di solito serve l’ordine per singolo ordine o pagamento, non un ordine globale.
Articoli correlati
Code asincrone ecommerce: backpressure, DLQ e replay sicuro
Come separare la conferma ordine dagli effetti asincroni e governare worker, retry, dead-letter queue e replay senza duplicare azioni o nascondere errori.
Webhook ecommerce affidabili: idempotenza, retry e osservabilità
Un blueprint operativo per ricevere eventi di ordini e pagamenti, evitare effetti duplicati, recuperare gli errori e rendere misurabile l'intera pipeline.
Prevenire l'overselling ecommerce con prenotazioni e controllo concorrenza
Un modello operativo per distinguere stock fisico, disponibile e riservato, assegnare le ultime unità in modo atomico e riconciliare gli errori tra canali.